Support-Ende für Ceph Squid am 31. Oktober: das Upgrade auf Tentacle und die CephX-Schlüssel, die Sie dabei tauschen müssen
Der Support für Ceph Squid endet am 31.10.2026. Was Tentacle ändert, die Upgrade-Reihenfolge für cephadm und Proxmox und welche CephX-Schlüssel Sie tauschen.
Für Ceph 19.2 Squid endet laut dem Release-Verzeichnis von Ceph am 31. Oktober 2026 der Support (End of Life). Am 1. November hört in Ihrem Cluster nichts auf zu funktionieren. Was aufhört, sind Fehlerbehebungen: Ein archiviertes Release bekommt keine Bugfixes und keine Backports mehr. Wie wichtig das ist, hat der 19. August 2026 gezeigt: Ceph hat vier CVEs in einem Release geschlossen und alle Betreiber aufgefordert, „so bald wie möglich" zu aktualisieren. Die nächste Korrektur dieser Art kommt nur noch für Tentacle. Dieser Artikel zeigt, was sich mit Ceph 20.2 Tentacle ändert, in welcher Reihenfolge Sie Cluster mit cephadm, paketbasierte Cluster und Proxmox VE aktualisieren und welche CephX-Schlüsselrotation das August-Release jedem Upgrade-Plan hinzugefügt hat.
Was passiert ist: Ein Sicherheitsrelease hat aus einem Routine-Upgrade zwei Schritte gemacht
Das Upgrade von einem stabilen Ceph-Release auf das nächste ist seit Jahren ein eingespielter Ablauf: Monitore, Manager, OSDs, MDS, RGW, dann das Mindest-Release der OSDs anheben. Daran hat sich nichts geändert. Geändert hat sich etwas durch das Sicherheitsrelease vom 19. August 2026, Squid 19.2.6 und Tentacle 20.2.4. Es schließt eine Authentifizierungsumgehung in CephX (CVE-2025-30156) und drei weitere Lücken im Monitor und im RADOS Gateway und führt einen neuen CephX-Schlüsseltyp ein: aes256k. Die korrigierten Binaries sind nur die halbe Lösung. Die andere Hälfte ist der Austausch der alten Schlüssel, und der betrifft jeden Client, der mit dem Cluster spricht.
Release        Erstes     Letztes Point-Rel.   Support-Ende
------------------------------------------------------------------
Reef 18.2      07.08.2023 18.2.8 (20.03.2026)  20.03.2026, archiviert
Squid 19.2     26.09.2024 19.2.7 (12.10.2026)  31.10.2026, geschätzt
Tentacle 20.2  18.11.2025 20.2.4 (19.08.2026)  01.06.2027, geschätzt
Quelle: docs.ceph.com/en/latest/releases, abgerufen am 27.10.2026.
Zwei Zahlen verdienen einen zweiten Blick. Das geschätzte Support-Ende von Tentacle ist Juni 2027: Das Release, auf das Sie jetzt aktualisieren, hat noch etwa sieben Monate Support. Und die Daten sind Schätzungen: Im Juli nannte das Verzeichnis für Squid noch den 19. September. Planen Sie das nächste große Upgrade für das erste Halbjahr 2027 ein und nutzen Sie dieses als Generalprobe.
Was Tentacle ändert und was es entfernt
Das meiste in Tentacle ist optional. Für einen bestehenden Cluster zählen diese Punkte:
- FastEC für Erasure-Coded-Pools. Partielle Lese- und Schreibzugriffe auf EC-Pools, pro Pool aktiviert mit dem Flag allow_ec_optimizations. Das Upgrade schaltet es nicht ein. Aktivieren Sie es zuerst für einen Pool und beobachten Sie ihn.
- Neuer Erasure-Code-Standard für neue Pools. Neue EC-Pools nutzen ISA-L statt Jerasure. Aktualisierte Cluster behalten ihre bisherigen Standardwerte.
- Schnelleres BlueStore-WAL und bessere Kompression. Kein Handlungsbedarf.
- Cephadm bekommt ein Management-Gateway, OIDC-Single-Sign-on über oauth2-proxy und eine interne Zertifikatsverwaltung. Nützlich, wenn mehrere Admins das Dashboard nutzen.
- Ein SMB-Manager-Modul, das Samba-Freigaben auf CephFS anlegt.
Zwei Punkte schaden, wenn Sie sie übersehen:
- Die Module mgr/restful und mgr/zabbix sind entfernt. Beide gelten seit 2020 als veraltet. Wenn Ihre Zabbix-Dashboards Ceph über das Manager-Modul lesen, bleiben sie nach dem Upgrade leer, ohne Alarm. Stellen Sie vor dem Wartungsfenster auf den Prometheus-Exporter oder die Dashboard-API um, nicht danach.
- Die Upgrade-Pfade sind eng. Tentacle akzeptiert Upgrades nur von Reef oder Squid, und es gibt kein Downgrade. Aktualisieren Sie direkt auf das neueste Tentacle-Point-Release: Ab Squid 19.2.6 starten Tentacle-Daemons älter als 20.2.4 nicht. Sobald Sie ceph osd require-osd-release tentacle ausführen, führt der Weg zurück nur über ein Backup.
Vor dem Wartungsfenster: sechs Prüfungen
- Zustand des Clusters. Keine Placement Groups im Zustand down, recovering, incomplete, undersized oder backfilling. Zeigt ceph -s nicht HEALTH_OK, beheben Sie das zuerst.
- Versionen. ceph versions muss überall dasselbe Release zeigen. Gemischte Point-Releases sind als Ausgangslage in Ordnung, gemischte Hauptversionen sind ein eigenes Projekt.
- Monitoring. Prüfen Sie mit ceph mgr module ls, ob restful oder zabbix aktiv sind (siehe oben).
- Clients. Listen Sie jeden Client des Clusters auf: Hypervisoren, Kubernetes-Nodes mit ceph-csi, Backup-Server, S3-Anwendungen. Notieren Sie für jeden, der RBD oder CephFS über den Kernel einbindet, die Kernel-Version. Diese Liste entscheidet über den CephX-Teil des Plans.
- Multisite-RGW. Wenn Sie zwischen Zonen replizieren, setzen Sie rgw_sigv4_insecure vor dem Start auf true und erst dann zurück auf false, wenn alle Zonen das neue Release fahren. Ohne diesen Schritt können S3-Anfragen zwischen aktualisierten und nicht aktualisierten Zonen fehlschlagen.
- Backups. Ein aktuelles Backup von allem, was Sie nicht neu aufbauen können, mit getesteter Wiederherstellung. Es gibt kein Downgrade.
Das Upgrade: Cluster mit cephadm
Mit cephadm übernimmt der Orchestrator die Reihenfolge. Schalten Sie den PG-Autoscaler für die Dauer ab, starten Sie das Upgrade und beobachten Sie es.
ceph osd pool set noautoscale
ceph orch upgrade start --image quay.io/ceph/ceph:v20.2.4
ceph orch upgrade status
ceph -W cephadm
# pausieren / fortsetzen / abbrechen (Abbrechen macht nichts rückgängig):
ceph orch upgrade pause
ceph orch upgrade resume
# nach dem Upgrade:
ceph osd pool unset noautoscale
ceph health detail
Quelle: Release Notes Ceph v20.2.0 Tentacle, ceph.io, 18.11.2025.
Seit 20.2.4 rotiert cephadm nach dem Image-Update außerdem die OSD- und MDS-Schlüssel auf aes256k. Das Upgrade dauert deshalb länger, als Sie es gewohnt sind. Client-Schlüssel werden nicht automatisch rotiert: Dieser Teil liegt bei Ihnen.
Das Upgrade: paketbasierte Cluster und Proxmox VE
Ohne cephadm ist die Reihenfolge Handarbeit. Zuerst die Monitore, dann Manager, OSDs, MDS und RGW, ein Node nach dem anderen. Zwischen zwei Nodes warten Sie, bis der Cluster wieder gesund ist.
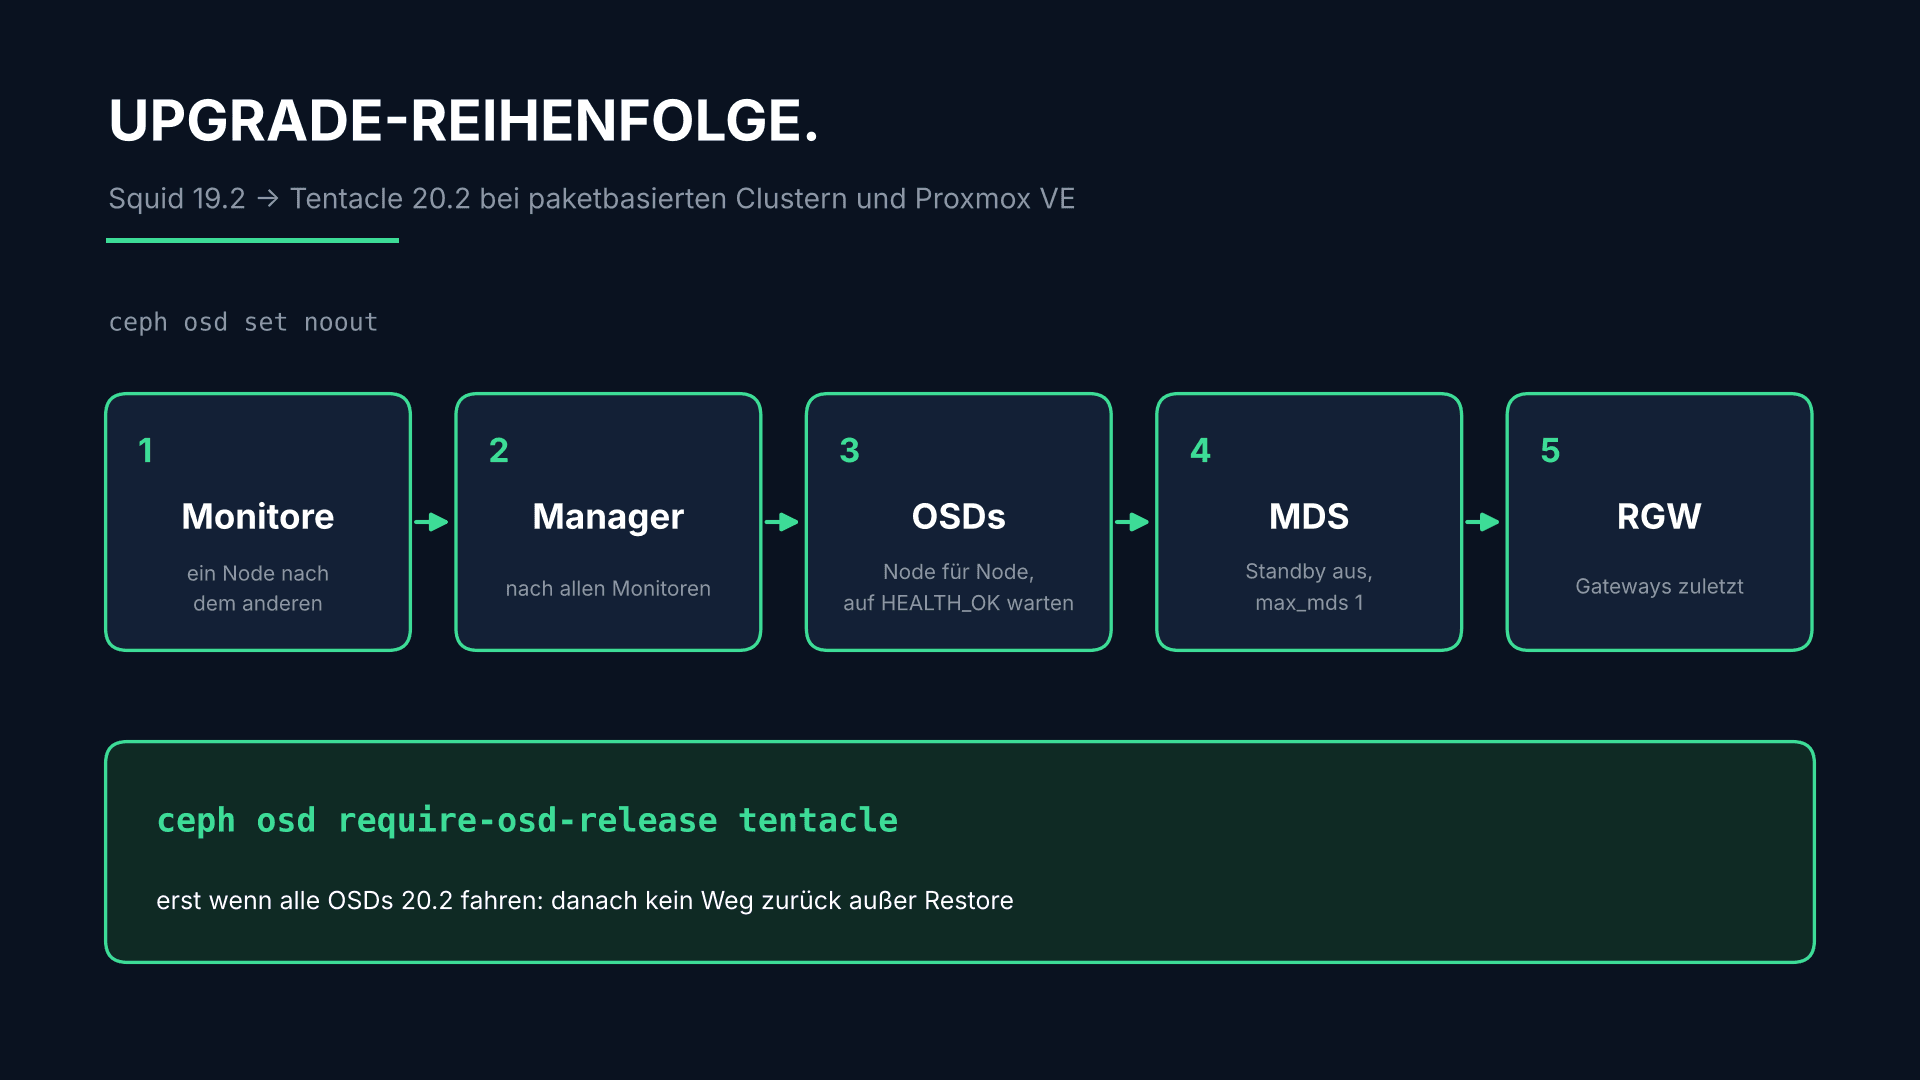
ceph osd set noout
# auf jedem Node: Tentacle-Pakete installieren (Proxmox VE: apt full-upgrade), dann
systemctl restart ceph-mon.target         # ein Node nach dem anderen
ceph mon dump | grep min_mon_release      # erwartet: 20 (tentacle)
systemctl restart ceph-mgr.target
systemctl restart ceph-osd.target         # ein Node nach dem anderen, auf HEALTH_OK warten
# CephFS, pro Dateisystem: vorher max_mds und allow_standby_replay notieren
ceph fs set <fs_name> allow_standby_replay false
ceph fs set <fs_name> max_mds 1
systemctl stop ceph-mds.target            # auf den Standby-MDS-Nodes
systemctl restart ceph-mds.target         # auf dem verbliebenen aktiven MDS
systemctl start ceph-mds.target           # auf den Standby-MDS-Nodes
ceph fs set <fs_name> max_mds <original_max_mds>
ceph fs set <fs_name> allow_standby_replay <original_value>
systemctl restart ceph-radosgw.target
# erst wenn alle OSDs 20.2 fahren:
ceph osd require-osd-release tentacle
ceph osd unset noout
Quellen: Release Notes Ceph v20.2.0 Tentacle; Proxmox-VE-Wiki „Ceph Squid to Tentacle".
Unter Proxmox VE gilt dieselbe Reihenfolge mit drei Ergänzungen aus der Upgrade-Anleitung von Proxmox. Die Nodes müssen ein aktuelles Proxmox VE 9 fahren: Die Anleitung nennt 9.1 als Minimum, die Proxmox-Ankündigung zur Schlüsselmigration vom September 9.2. Ein Cluster, der noch auf Proxmox VE 8 läuft, braucht dieses Upgrade vorher, in einem eigenen Wartungsfenster. Der Wechsel des Repositorys ist auf jedem Node eine Zeile: squid wird in /etc/apt/sources.list.d/ceph.sources zu tentacle. Und OSDs, die unter Ceph Octopus oder früher angelegt wurden, können nach dem Upgrade wachsenden META-Verbrauch zeigen (bekannt bis einschließlich 20.2.4): Prüfen Sie die Spalte META in ceph osd df und kompaktieren Sie diese OSDs nacheinander außerhalb der Lastspitzen mit ceph daemon osd.<id> compact.
Der neue Teil: CephX-Schlüssel auf aes256k rotieren
Sobald der erste Tentacle-Monitor läuft, meldet der Cluster eine Reihe von AUTH_INSECURE-Warnungen und -Fehlern, bis hin zu HEALTH_ERR. Sie sind erwartet. Sie sagen, dass der Cluster den alten Schlüsseltyp noch verwendet und akzeptiert, und sie verschwinden Schritt für Schritt, während Sie ihn ersetzen. Die Reihenfolge zählt: zuerst die Service-Schlüssel, dann die Client-Schlüssel, und erst wenn jeder Client mit seinem neuen Schlüssel arbeitet, akzeptieren Sie die alten nicht mehr. Die Dokumentation der Health Checks sagt ausdrücklich: AUTH_INSECURE_KEYS_ALLOWED nicht vor AUTH_INSECURE_SERVICE_KEY_TYPE auflösen.
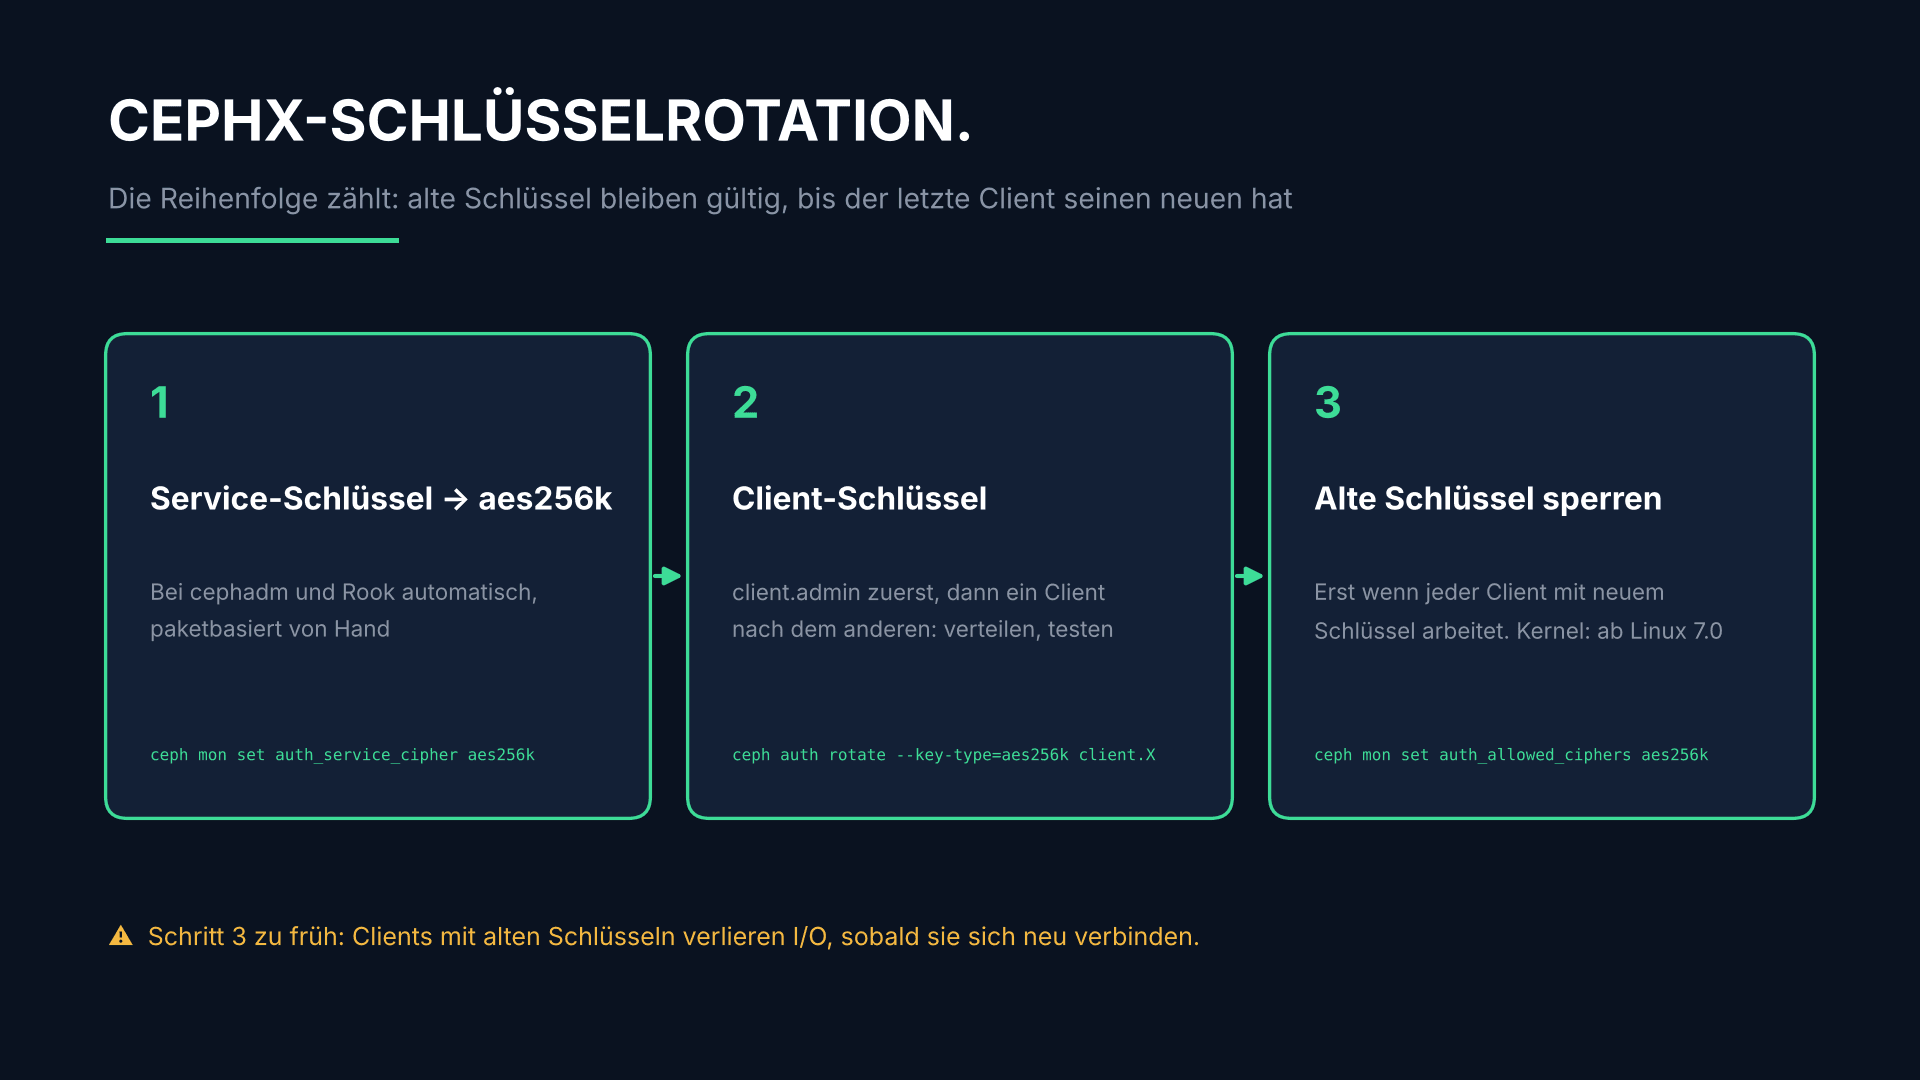
# 1. Service-Schlüssel (bei cephadm und Rook automatisch, paketbasiert von Hand)
ceph auth rotate --key-type=aes256k mds.a > MDS_A_KEYRING
#    sobald alle Service-Daemons ein korrigiertes Release fahren:
ceph mon set auth_service_cipher aes256k
# 2. Client-Schlüssel, client.admin zuerst: ein Client nach dem anderen, neuen Keyring verteilen, testen, weiter
ceph auth rotate --key-type=aes256k client.X > CLIENT_X_KEYRING
# 3. Erst wenn jeder Client mit seinem neuen Schlüssel arbeitet:
ceph mon set auth_allowed_ciphers aes256k
ceph config set mon mon_auth_allow_insecure_key false
Quelle: docs.ceph.com, RADOS Health Checks, Abschnitt AUTH_INSECURE_*, abgerufen am 27.10.2026.
Rotieren Sie client.admin zuerst und legen Sie den neuen Schlüssel in Ihren Admin-Keyring: Sobald der Cluster nur noch aes256k akzeptiert, sperrt Sie ein alter Admin-Schlüssel aus.
Die Falle ist der Kernel. Kernel-Clients für RBD und CephFS unterstützen aes256k ab Linux 7.0, mit Backports in CentOS Stream 9 und 10; für andere Distributionen fragen Sie Ihren Hersteller. Ein Hypervisor oder Kubernetes-Node mit älterem Kernel arbeitet nur so lange weiter, wie der Cluster den alten Schlüsseltyp akzeptiert. Schränken Sie die Cipher ein, bevor dieser Client aktualisiert ist, schlägt sein I/O fehl, sobald er sich neu verbindet oder seine Service-Tickets ablaufen: Minuten oder Tage später. Unter Proxmox VE hält das Skript pve-cephx-rotate-service-keys aus der Proxmox-Ankündigung zur Schlüsselmigration alte und neue Schlüssel parallel gültig, während Sie die Clients aktualisieren, auch laufende Gäste und CephFS-Mounts. Ohne --apply macht es nur einen Probelauf: Beginnen Sie damit.
Was wir bei diesem Upgrade in der Praxis gesehen haben
Wir haben dieses Upgrade auf einem produktiven Proxmox-VE-Cluster durchgeführt. Sechs Dinge, die wir jedem Team vor seinem Wartungsfenster sagen würden:
- Der Cluster wird rot, sobald der erste Tentacle-Monitor läuft. Alle internen cephx-Schlüssel wurden mit AES-128 erzeugt, und Tentacle markiert sie als unsicher (CVE-2025-30156). Kaputt ist nichts, aber der Cluster bleibt auf HEALTH_ERR, bis die Schlüssel ersetzt sind. Planen Sie die Rotation als eigene Änderung und schalten Sie die AUTH_INSECURE-Warnungen während des Upgrades stumm, damit echte Probleme sichtbar bleiben.
- Die Service-Schlüssel dauerten Minuten, der Admin-Schlüssel eine Nacht. Das Proxmox-Skript hat die Schlüssel von Monitoren, Managern, OSDs und MDS im laufenden Betrieb rotiert. Der Admin-Schlüssel ist anders: Jede laufende VM hält ihn offen, und ein Neustart im Gast reicht nicht. Jede VM muss einmal live migriert werden, um den neuen Schlüssel zu übernehmen. Wir haben alle VMs des Clusters in einer Nacht verschoben, jede mit deutlich unter einer Sekunde Unterbrechung.
- Kubernetes-Nodes behalten den alten Schlüsseltyp. Nodes mit aktuellen Ubuntu-LTS-Kerneln (5.15 und 6.8) können aes256k nicht nutzen. Deshalb konnten wir den Cluster nicht auf den neuen Cipher beschränken und haben die restlichen Warnungen stummgeschaltet, statt ihn zu erzwingen.
- Ein kurzer Netzwerkausfall in der Paketphase wurde für einige CephFS-Clients zu einer Stunde Ausfall. Während die Host-Pakete aktualisiert wurden, verloren die VMs auf jedem Host etwa eine Minute lang das Netzwerk: ein Problem auf Hypervisor-Seite, nicht in Ceph. Die Verbindungen der Kubernetes-Nodes zu den Metadatenservern kamen nicht zurück, die Clients wurden nach fünf Minuten entfernt und für eine Stunde auf die Blocklist gesetzt. Mounts mit recover_session=clean verbanden sich nach Ablauf der Blocklist von selbst neu. Die anderen blieben hängen, bis wir sie von Hand repariert haben. Das gilt über das Upgrade hinaus: Jeder CephFS-Kernel-Client kann nach einem Netzwerkaussetzer, einem Host-Failover oder einem MDS-Neustart auf der Blocklist landen. Mit recover_session=clean erholt sich der Mount von selbst; dafür gehen ungeschriebene Daten von vor der Trennung verloren, für die meisten Workloads das kleinere Übel gegenüber einem hängenden Mount. Neuere ceph-csi-Versionen setzen die Option standardmäßig; prüfen Sie, ob Ihre es tut.
- Der Ceph-Teil selbst war unspektakulär. Der Neustart von Monitoren, Managern, OSDs und MDS im ganzen Cluster dauerte etwa 16 Minuten, und jeder Storage-Host war innerhalb von 40 Sekunden nach seinem Neustart wieder gesund. Die Vorbereitung (Health Check, Versionsprüfung, aufgezeichnete Baseline, geprüfte Backups) macht es so unspektakulär.
- Verschieben Sie Workloads nicht sofort auf einen frisch neu gestarteten Host. Nach den anschließenden Reboots verloren zwei Kubernetes-Nodes, die auf einen gerade neu gestarteten Host migriert wurden, alle Storage-Verbindungen und mussten zurückgesetzt werden. Prüfen Sie einen frisch gestarteten Host zuerst mit einer Test-VM: RBD-Volumes in einem Gast erholen sich nicht von einem langen Ausfall.
Wann Sie warten sollten
Starten Sie das Upgrade nicht in der letzten Oktoberwoche, nur wegen eines Datums. Ein ungesunder Cluster, ein Monitoring, das am Zabbix-Modul hängt, oder eine Flotte von Kernel-Clients, die Sie diesen Monat nicht aktualisieren können, sind gute Gründe, ein paar Wochen zu warten. Das Support-Ende allein ist kein Grund zur Eile. Squid 19.2.7 enthält die Sicherheitskorrekturen vom August bereits. Was es nicht mehr bekommt, ist die nächste. Wenn Sie vorerst auf Squid bleiben, schreiben Sie auf, wann Sie wechseln und was Sie bis dahin aufhält.
Was wir tun
Hostzero plant, baut und betreibt Ceph-Cluster in Frankfurt, bei Ihnen vor Ort oder hybrid. Mit Managed Ceph gehören Upgrades wie dieses zum Betrieb: Wir prüfen Zustand, Clients und Kernel, planen das Wartungsfenster, führen Upgrade und CephX-Rotation durch und bleiben in Bereitschaft, bis die Warnungen verschwunden sind. Managed Ceph Operations beginnen bei 500 € im Monat. Wenn Sie den Cluster selbst betreiben und nur dieses Upgrade erledigt haben wollen, bieten wir es nach einem Health Check an. Für Cluster, die bereits Probleme haben, gibt es unseren Notfall-Support mit Datenrettung rund um die Uhr für 250 € pro Stunde, auch für Cluster, die wir nicht gebaut haben. Das Tuning nach dem Upgrade beschreibt unser Artikel über Linux-Standards, die Ceph ausbremsen, die Trennung von Kubernetes-Mandanten auf einem Cluster unser Artikel über mandantenfähiges ceph-csi. Alle Preise netto, Stand Oktober 2026.
Häufige Fragen
Wann endet der Support für Ceph Squid?
Das Release-Verzeichnis von Ceph nennt den 31. Oktober 2026, als Schätzung markiert. Danach bekommt Squid keine Bugfixes und keine Backports mehr. Der Cluster läuft weiter.
Kann ich direkt von Reef auf Tentacle aktualisieren?
Ja. Tentacle akzeptiert Upgrades von Reef 18.2 und Squid 19.2. Ältere Releases wie Quincy müssen zuerst auf Reef oder Squid. Egal, von wo Sie starten: Aktualisieren Sie auf das neueste Tentacle-Point-Release. Unter Proxmox VE setzt das Ceph-Upgrade außerdem ein aktuelles Proxmox VE 9 voraus.
Kann ich nach dem Upgrade zurück auf Squid?
Nein. Es gibt keinen Downgrade-Pfad. Sobald ceph osd require-osd-release tentacle gesetzt ist, führt der Weg zurück nur über ein Backup. Deshalb steht die Backup-Prüfung vor dem Wartungsfenster.
Muss ich die CephX-Schlüssel rotieren?
Der neue Schlüsseltyp kommt mit der Korrektur für CVE-2025-30156, eine Authentifizierungsumgehung in CephX. Bis Sie rotieren, meldet der Cluster AUTH_INSECURE-Warnungen und akzeptiert weiter die alten Schlüssel. Cephadm rotiert die Daemon-Schlüssel automatisch, Rook zusätzlich einige Client-Schlüssel. Die übrigen Client-Schlüssel und alle Schlüssel in paketbasierten Clustern rotieren Sie von Hand.
Wie lange dauert das Upgrade?
Das hängt von der Zahl der OSDs ab und davon, wie lange jeder Node braucht, bis der Cluster wieder HEALTH_OK meldet. Bei cephadm verlängert die Schlüsselrotation nach dem Image-Update die Laufzeit. Planen Sie die Rotation der Client-Schlüssel als eigenen Schritt, nicht als Teil der Upgrade-Nacht.
Haben Sie Fragen zu diesem Thema?
Unsere Experten beraten Sie gerne zu Ihrer individuellen Strategie.
Beratungsgespräch vereinbaren