
Mandantenfähiges Kubernetes auf einem Ceph-Cluster: RBD und CephFS pro Mandant isolieren mit ceph-csi
Ein Ceph-Cluster, viele Kubernetes-Mandanten: CephX-Caps, RADOS-Namespaces und mgr-Grants gegen mandantenübergreifenden CephFS-Zugriff — mit ISO-27001-Nachweis.
Wer mehreren Kunden Kubernetes-Cluster bereitstellt und sie mit einem Ceph-Cluster hinterlegt, landet bei ceph-csi als Treiber. Mit den Capabilities aus der eigenen Dokumentation ist ceph-csi allerdings auch vier mandantenübergreifende Pfade in einem Key: Wer das csi-cephfs-secret eines Clusters besitzt, kann die CephFS-Volumes aller anderen Cluster read-only mounten, jedes Objekt im gemeinsamen Data-Pool auflisten und die CSI-Buchführung der anderen Cluster löschen. In einem mandantenfähigen Setup liegt dieser Key in einem Kubernetes-Secret, das jeder cluster-admin des Mandanten lesen kann.
Dieser Artikel beschreibt eine Konfiguration, die das schließt — geprüft auf Ceph Squid mit ceph-csi v3.17 über ceph-csi-operator 1.0.5 (September 2026; die Cap-Grammatik ist in Tentacle unverändert) — und wie bestehende Volumes hineinmigriert werden. Nichts davon braucht eigene Dateisysteme, MDS- oder mgr-Daemons pro Mandant.
Das Setup
- Ein Ceph-Cluster, ein CephFS-Dateisystem (kubernetes_cephfs), ein RBD-Pool pro Mandant.
- Ein Kubernetes-Cluster pro Mandant, jeder mit eigenem ceph-csi-Deployment und zwei CephX-Usern: k8s-<t>-rbd und k8s-<t>-ceph.
- Die CephFS-Volumes eines Mandanten liegen in einer eigenen Subvolume Group /volumes/<t>-csi, gesetzt über subVolumeGroup im ceph-csi-ClientProfile.
RBD ist die einfache Hälfte. Pool-bezogene Caps (osd allow rwx pool=<tenant>, mon profile rbd) sind eine harte Grenze, und das RBD-Journal von ceph-csi liegt innerhalb dieses Pools. Alles Weitere betrifft CephFS, wo der Pool geteilt wird.
Wo die Upstream-Vorlage von ceph-csi undicht ist
Die ceph-csi-Dokumentation gibt für CephFS diesen User vor:
mon  allow r fsname=kubernetes_cephfs
mgr  allow rw
osd  allow rw tag cephfs metadata=kubernetes_cephfs, allow rw tag cephfs data=kubernetes_cephfs
mds  allow r fsname=kubernetes_cephfs path=/volumes, allow rws fsname=kubernetes_cephfs path=/volumes/<group>
Sie geht von einem Mandanten pro Dateisystem aus. Mit mehreren Mandanten öffnet sie vier Pfade:
Cap | Was ein Mandanten-Key damit kann |
|---|---|
mds allow r path=/volumes | /volumes read-only mounten und die Dateien aller anderen Mandanten lesen. |
osd allow rw tag cephfs data=… | rados ls / rados get auf den gesamten Data-Pool: die Dateiinhalte aller Mandanten — ohne Namen, aber die Daten. |
osd allow rw tag cephfs metadata=… | Rohe MDS-Metadatenobjekte lesen und schreiben, dazu das CSI-Journal aller Cluster (RADOS-Namespace csi), inklusive Löschen der PV-Buchführung anderer Cluster. |
mgr allow rw | Jedes mgr-Kommando: Subvolumes in jeder Gruppe auflisten, anlegen, löschen, ceph orch ausführen. |
ceph fs subvolume create --namespace-isolated hilft nicht: Es legt einen Namespace pro Subvolume an und setzt einen Key pro Subvolume voraus. ceph-csi hat einen Key pro Cluster und setzt das Flag mit Stand v3.17 nie — ein offener Pull Request (ceph-csi #6358) würde einen StorageClass-Parameter namespaceIsolated ergänzen, isoliert aber auch nach dem Merge pro Subvolume statt pro Mandant und ändert nichts an den mgr- und Journal-Caps.
Das Cap-Set, das hält
mon  allow r fsname=kubernetes_cephfs
mds  allow rwps fsname=kubernetes_cephfs path=/volumes/<t>-csi
osd  allow rw pool=customers_cephfs_metadata namespace=<t>,
     allow rw namespace=<t> tag cephfs data=kubernetes_cephfs
mgr  allow command "fs volume ls",
     allow command "<cmd>" with vol_name=kubernetes_cephfs group_name=<t>-csi     # für jedes <cmd> unten
     allow command "fs subvolume snapshot clone" with vol_name=kubernetes_cephfs group_name=<t>-csi target_group_name=<t>-csi
Die mgr-Kommandos, die ceph-csi v3.17 absetzt, und damit die 21 <cmd>-Grants:
fs subvolume create        fs subvolume snapshot create      fs subvolume snapshot metadata set
fs subvolume rm            fs subvolume snapshot rm          fs subvolume snapshot metadata rm
fs subvolume resize        fs subvolume snapshot info        fs subvolume snapshot metadata ls
fs subvolume getpath       fs subvolume snapshot ls          fs subvolume snapshot protect
fs subvolume info          fs subvolume snapshot getpath     fs subvolume snapshot unprotect
fs subvolume exist         fs clone status                   fs clone cancel
fs subvolume metadata set  fs subvolume metadata rm          fs subvolume metadata ls
Dazu fs volume ls (ohne Gruppenargument, beim Start verwendet) und fs subvolume snapshot clone mit der zusätzlichen Einschränkung target_group_name, damit ein Klon nicht in eine andere Gruppe geschrieben werden kann. 23 Grants. Die Liste ändert sich zwischen Releases; für eine andere ceph-csi-Version stehen die Kommandostrings als "prefix"-Werte im Paket cephfs/admin von go-ceph (in ceph-csi vendored), und internal/cephfs/core zeigt, welche seiner Methoden ceph-csi aufruft. Oder: einen PVC-Lebenszyklus gegen einen Key mit diesen Grants fahren und die Treiber-Logs nach EACCES durchsuchen.
Vier Ebenen, jede schließt eine Zeile der Tabelle oben.
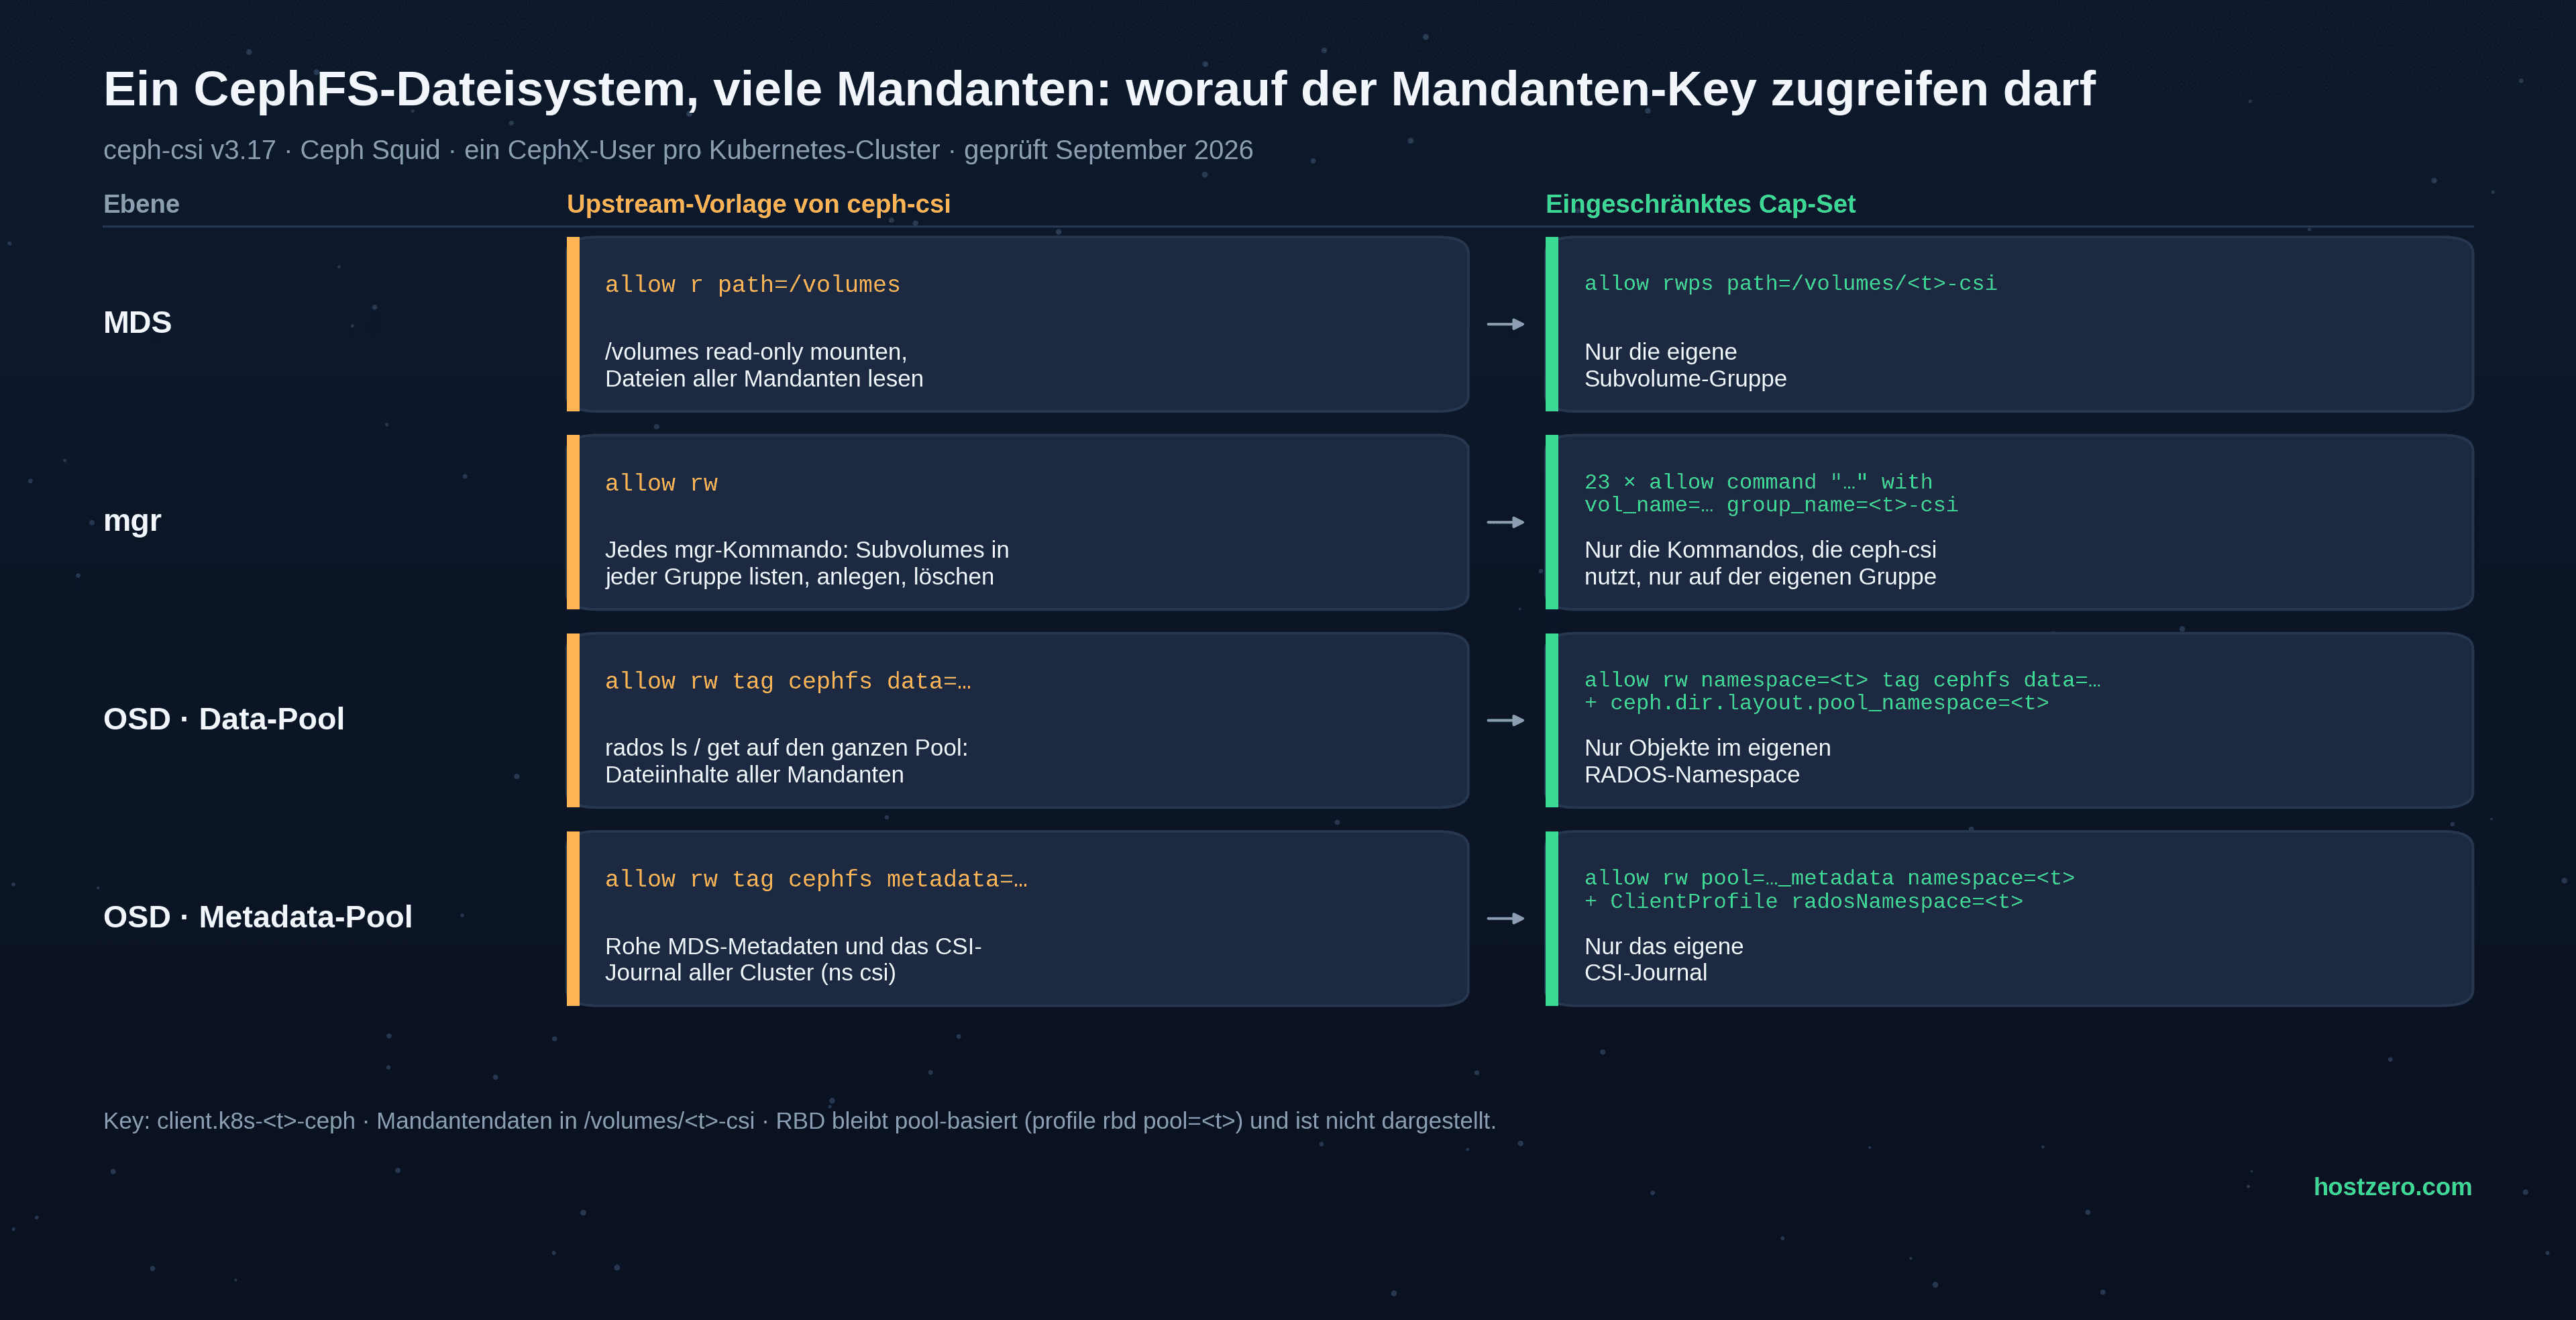
MDS: Pfad-Cap nur auf die Gruppe. rwps auf /volumes/<t>-csi und nichts auf /volumes. ceph-csi mountet nie oberhalb der Gruppe; der Kernel-Client mountet den Subvolume-Pfad direkt. p wird für Quotas gebraucht (ceph.quota.max_bytes), die ceph-csi beim Resize setzt, s für Snapshots.
mgr: ein Grant pro Kommando, mit Argument-Einschränkungen. ceph-csi v3.17 nutzt 23 mgr-Kommandos. allow command "<cmd>" with vol_name=… group_name=… lässt den mgr den Aufruf ablehnen, wenn diese Argumente nicht vorhanden und gleich sind; fs subvolume rm gegen eine andere Gruppe scheitert also mit EACCES. fs subvolume ls fehlt absichtlich: ceph-csi nutzt es nicht, und es würde andere Gruppen auflisten. allow module volumes with group_name=… leistet das nicht; Modul-Grants validieren die Argumente einzelner Kommandos nicht.
OSD-Data-Pool: ein RADOS-Namespace pro Mandant. CephFS erlaubt einem Verzeichnis ein Layout mit pool_namespace; darunter angelegte Dateien erben es, und die OSD-Cap-Grammatik akzeptiert namespace=<t> tag cephfs data=…. Einmal pro Mandant als Admin auf einem Mount des Dateisystems setzen:
setfattr -n ceph.dir.layout.pool_namespace -v <t> /volumes/<t>-csiNeue Subvolumes erben es (das mgr-Modul volumes setzt nur layout.pool; der MDS füllt den Rest aus dem nächsten übergeordneten Layout), Klone und Snapshot-Restores behalten es. Von da an liegen die Datenobjekte des Mandanten im Namespace <t>, und der Key sieht sonst nichts im Pool. Das muss vor der ersten PVC passieren; die Isolation hängt von der Reihenfolge ab.
OSD-Metadata-Pool: Journal-Namespace. ceph-csi speichert seine Zuordnung PV↔Subvolume als omap-Objekte (csi.volumes.default, csi.volume.<uuid>, csi.snaps.default, …) im Metadata-Pool, standardmäßig im RADOS-Namespace csi. ClientProfile.spec.cephFs.radosNamespace: <t> verschiebt es, und die Cap engt sich auf diesen Namespace ein. Das Feld ist nach dem Setzen unveränderlich. Der Helm-Chart ceph-csi-drivers 1.0.5 rendert es noch nicht (ceph-csi-operator #629, Fix in #630, beide September 2026); bis der Fix ausgeliefert ist, erledigt das ein Flux-postRenderers-Patch auf dem ClientProfile:
postRenderers:
  - kustomize:
      patches:
        - target: {kind: ClientProfile, name: <clusterID>}
          patch: |
            - op: add
              path: /spec/cephFs/radosNamespace
              value: <t>
Rohe MDS-Metadatenobjekte (Inode-Backtraces, Verzeichnisfragmente) liegen im Default-Namespace des Metadata-Pools, der Mandanten-Key kommt also auch an sie nicht heran.
Einen neuen Mandanten aufnehmen
Die Reihenfolge ist entscheidend, weil die Isolation im Data-Pool nur für Dateien gilt, die nach dem Setzen des xattr entstehen:
- ceph fs subvolumegroup create kubernetes_cephfs <t>-csi
- setfattr -n ceph.dir.layout.pool_namespace -v <t> /volumes/<t>-csi auf einem Admin-Mount
- ceph auth get-or-create client.k8s-<t>-ceph mit dem Cap-Set oben; client.k8s-<t>-rbd mit profile rbd pool=<t>
- ClientProfile mit subVolumeGroup: <t>-csi und cephFs.radosNamespace: <t>, Secrets im Namespace des Treibers
- Abnahmetest (unten), dann Übergabe des Clusters
Bestehende Mandanten migrieren
Cluster, die bereits auf der Upstream-Vorlage laufen, brauchen zwei Migrationen. Beide funktionieren online — außer für Dateien, die in-place geschrieben werden.
Namespace im Data-Pool. Das Layout einer Datei steht bei ihrer Erstellung fest; Dateien, die vor dem xattr geschrieben wurden, bleiben also im Default-Namespace, bis sie neu geschrieben werden. Pro Mandant: das xattr auf dem Gruppenverzeichnis und auf jedem bestehenden <subvolume>/<uuid>-Verzeichnis setzen (die tragen ein eigenes Layout), dann jede reguläre Datei mit cp -a f f.tmp && mv -f f.tmp f neu schreiben, Hardlinks und in den letzten Minuten geänderte Dateien überspringen, und einen zweiten Durchlauf fahren. mv ist atomar, Leser sehen nie eine halbe Datei, und eine Datei, die die Anwendung währenddessen anlegt, liegt bereits im neuen Namespace. Sicher für Write-once-Daten; bei in-place geschriebenen Dateien (SQLite, MySQL, Grafana) Pod stoppen, neu schreiben, starten. Als Größenordnung: ein einzelner Admin-Host mit Kernel-Mount und 12 parallelen Workern schafft etwa 150 MiB/s oder 500 Dateien/s, je nachdem, was zuerst limitiert — ein 40-GiB-Volume mit 375.000 Dateien dauert rund 12 Minuten, ein Neustart einer kleinen Datenbank 30 bis 120 Sekunden. Vor dem Einengen der Cap: getfattr -n ceph.file.layout.pool_namespace muss auf jeder Datei <t> liefern. Danach: ein vollständiges Lesen aller Dateien über den Mandanten-Key, und rados -p <data> ls mit diesem Key muss abgelehnt werden.
Zwei Dinge werden überraschen. Das Neuschreiben gibt jeder Datei eine neue Inode, der nächste Velero/kopia-Lauf scannt also alles neu (Dedup hält den Upload klein; der Scan ist der Preis). Dateien in bestehenden CephFS-Snapshots behalten ihr altes Layout, bis der Snapshot abläuft. Und der Data-Pool behält danach pro Datei ein Null-Byte-Objekt im Default-Namespace: MDS-Backtraces, die unabhängig vom Dateilayout dort geschrieben werden und von cephfs-data-scan und Scrub gebraucht werden. Sie enthalten keine Daten, und die Mandanten-Cap verweigert sie. Stehen lassen.
Journal-Namespace. Die csi.volume.<uuid>-Objekte des Mandanten und ihre csi.volume.<pv>-Keys aus dem Namespace csi nach <t> kopieren (ein 60-Zeilen-librados-Skript; welche Einträge zum Mandanten gehören, ergibt sich aus der PV-Liste des Clusters), die Cap ändern, Controller- und Node-Plugins von ceph-csi neu starten, das ClientProfile umstellen, einen PVC-Lebenszyklustest fahren, die kopierten Einträge aus csi löschen. Der Neustart ist nicht optional: librados-Sessions behalten die Caps, mit denen sie geöffnet wurden, und ein lange laufendes Plugin scheitert bei jedem Journal-Zugriff mit rados: ret=-1, Operation not permitted, bis es neu verbindet. Kernel-Mounts bleiben vom Plugin-Neustart unberührt.
Abnahmetest
Für jeden Mandanten, nach jeder Cap-Änderung, aus dem Cluster des Mandanten mit dem Secret des Mandanten: eine PVC anlegen und beschreiben, sie und eine bestehende PVC snapshotten, eine bestehende PVC neu mounten, aus dem Snapshot wiederherstellen und klonen, vergrößern, alles löschen; dann die ceph-csi-Logs nach EACCES und permission denied durchsuchen. Von einem Admin-Host mit dem Mandanten-Key: die Gruppe eines anderen Mandanten mounten (muss scheitern), rados ls auf den Default-Namespace des Data-Pools und auf den Namespace eines anderen Mandanten (muss scheitern), fs subvolume ls auf eine andere Gruppe (muss scheitern). Rund 3 Minuten pro Cluster; als Skript.
Was das mit ISO 27001 zu tun hat
Mandantentrennung auf gemeinsam genutztem Storage ist genau die Art von Kontrolle, nach der ein ISO-27001-Auditor fragt und die meist nur im Kopf von jemandem existiert. Annex A 5.15 (Zugangssteuerung) und 8.3 (Informationszugangsbeschränkung) der ISO 27001:2022 verlangen, dass die Regel „der Zugriff eines Kunden endet an seiner Namespace-Grenze“ technisch durchgesetzt und nachweisbar ist; das Cap-Set oben ist die Durchsetzung, der Abnahmetest der Nachweis. Zwei weitere Punkte gehören daneben ins ISMS:
- Die Reihenfolge der Onboarding-Schritte ist eine Kontrolle. Gruppe, Namespace-xattr, CephX-User, ClientProfile, erste PVC. Wer das xattr nach der ersten PVC setzt, hat die ersten Volumes des Mandanten ungeschützt. Das gehört in eine schriftliche Prozedur mit Checkliste, nicht in ein Chatprotokoll.
- Caps begrenzen, was ein geleakter Key kann; sie verhindern den Leak nicht. Ein Mandant mit cluster-admin auf seinem Cluster liest csi-cephfs-secret jederzeit. Namespace-gebundene admin-RoleBindings statt cluster-admin und CSI-Secrets im Namespace des Treibers statt in default sind die andere Hälfte. Ebenso, geteiltes Material aus Mandanten-Secrets herauszuhalten: eine RBD-encryptionPassphrase, die von einem Cluster-Secret ins nächste kopiert wurde, ist an dem Tag ein gemeinsamer Schlüssel für alle Mandanten, an dem jemand encrypted: "true" an einer StorageClass setzt.
Wann ein gemeinsamer Cluster die falsche Antwort ist
Wenn Vertrag oder Regulator eines Kunden physisch getrennten Storage verlangen — eigene Hardware, eigene Failure Domain, eigene Schlüsselhierarchie —, ersetzt kein Cap-Set das, und ein dedizierter Ceph-Cluster ist das ehrliche Angebot. Dasselbe gilt für zwei oder drei Mandanten mit sehr unterschiedlichen Lastprofilen: Ein gemeinsames Dateisystem teilt seinen MDS, und der Metadaten-Sturm eines Mandanten ist die Latenz aller. Die Konfiguration oben ist für den häufigen Fall dazwischen: Dutzende Mandanten, gewöhnliche Vertraulichkeitsanforderungen, ein Storage-Team.
Was wir bei Hostzero tun
Wir betreiben Ceph und Kubernetes für Unternehmen aus der EU aus unserem Rechenzentrum in Frankfurt: gemeinsam genutzte Ceph-Cluster hinter vielen Kunden-Kubernetes-Clustern, betrieben unter unserem ISO-27001-ISMS. Die Konfiguration oben wenden wir bei jedem Mandanten an — auf denselben Clustern, die wir in Ceph als Alternative zu MinIO beschrieben haben. Wenn Sie einen Ceph-Cluster planen oder einen zweiten Blick auf Ihren bestehenden wollen: Ceph-Storage-Cluster — Planung und Services und Kubernetes-Cluster in Deutschland.
Häufige Fragen
Brauche ich ein eigenes CephFS-Dateisystem oder einen eigenen MDS pro Mandant?
Nein. MDS-Pfad-Caps, mgr-Kommando-Grants und RADOS-Namespaces geben mandantenweise Isolation auf einem Dateisystem mit einem Satz Daemons. Getrennte Dateisysteme kosten je ein MDS-Paar und skalieren nicht auf Dutzende Mandanten.
Löst --namespace-isolated bei fs subvolume create das Problem?
Nein. Es legt einen Namespace pro Subvolume an und erwartet einen Key pro Subvolume. ceph-csi nutzt einen Key pro Cluster und übergibt das Flag mit Stand v3.17 nie. Der Namespace pro Mandant auf dem Gruppenverzeichnis erreicht dasselbe auf der richtigen Granularität.
Warum nicht allow module volumes für die mgr-Cap?
Modul-Grants akzeptieren eine with-Klausel, validieren aber die Argumente einzelner Kommandos nicht; group_name=-Einschränkungen werden ignoriert. Grants pro Kommando werden validiert (MgrCapGrant::validate_arguments verlangt, dass die eingeschränkten Keys vorhanden und gleich sind).
Kann ich radosNamespace an einem bestehenden ClientProfile ändern?
Das erste Setzen funktioniert; eine spätere Änderung wird abgelehnt (CEL-Regel self == oldSelf). Journal-Einträge vor dem Setzen kopieren.
Wie lange ist ein Mandant während der Migration offline?
Null bei Write-once-Daten (Uploads, Medien, statische Assets). Bei einer Datenbank auf CephFS: das Neuschreiben ihrer Dateien plus ein Pod-Neustart, typisch 30 bis 120 Sekunden. Datenbank-Volumes sind ohnehin meist besser auf RBD aufgehoben; das Migrationsfenster ist ein guter Moment, sie zu verschieben.
Was will ein ISO-27001-Auditor bei Mandantentrennung auf gemeinsamem Ceph-Storage sehen?
Drei Dinge: die Regel (eine schriftliche Zugriffsrichtlinie, die sagt, wo der Zugriff eines Mandanten endet), die Durchsetzung (das CephX-Cap-Set pro Mandant, exportiert mit ceph auth get) und den Nachweis, dass es wirkt (die Ergebnisse des Abnahmetests, datiert, pro Mandant, nach jeder Cap-Änderung). Die Onboarding-Prozedur mit ihrer festen Schrittfolge ist das vierte Dokument; sie zeigt, dass die Kontrolle konsistent angewendet wird, nicht einmalig.
Haben Sie Fragen zu diesem Thema?
Unsere Experten beraten Sie gerne zu Ihrer individuellen Strategie.
Beratungsgespräch vereinbaren