
Proxmox-VM-Migration ohne Verlust der öffentlichen IP: BGP, FRR und NetBox mit dem Open-Source-Network-Reconciler
Proxmox HA verschiebt die VM, nicht ihre öffentliche IP. So routen wir öffentliche IPs per BGP/FRR und NetBox zur migrierten VM: gemessene Ausfallzeit, Open-Source-Code.
Proxmox HA verschiebt eine ausgefallene VM in unter einer Minute auf einen gesunden Node. Die öffentliche IP verschiebt es nicht. Der Router schickt den Traffic weiter an den alten Node, die NAT-Regel liegt weiter auf dem alten Node, und aus Kundensicht ist der Dienst so lange down, bis jemand das Routing von Hand repariert. In einem Drei-Node-Labor haben wir gemessen, was passiert, wenn das Routing stattdessen automatisch nachgezogen wird: Die Live-Migration einer VM auf lokalem LVM-Storage kostete 3 von 45 Pings. Eine VM auf LINSTOR-Shared-Storage verlor keinen einzigen.
Dieser Artikel beschreibt das Setup: FRR spricht BGP zwischen den Nodes und einem Router, NetBox ist die Source of Truth für öffentliche IPs, und ein kleiner Daemon von uns, der Network-Reconciler, setzt NAT- und Routenänderungen auf dem Node um, auf dem die VM gerade läuft. Den Daemon und den Event-Bus, auf dem er aufsetzt, veröffentlichen wir als Open Source.
Das Problem: Die VM wandert, das Netzwerk nicht
Virtuelle Maschinen in einem Cluster betreiben oft Dienste oder API-Endpunkte, die über öffentliche IPs erreichbar sein müssen. In einem kleinen Cluster konfigurieren Sie das einmal pro VM auf dem Node, auf dem die VM liegt, und vergessen es. Mit wachsendem Cluster bricht dieses Modell an zwei Stellen.
Erstens die Größe: Dutzende VMs mit je einer NAT-Regel und einer statischen Route auf einem bestimmten Node werden zu einer Tabelle, der niemand mehr traut. Zweitens die VM-Migration. Fällt ein Node aus, wird er für Wartung heruntergefahren oder eine VM zur Lastverteilung verschoben, liegt die VM nicht mehr dort, wo der Router sie erwartet. Je nach Netzdesign heißt Erreichbarkeit wiederherstellen: Router umkonfigurieren (und manchmal neu starten), NAT-Eintrag auf dem alten Node löschen, auf dem neuen anlegen, und vorher womöglich die richtige Konfiguration aus einer externen Quelle holen. Jeder dieser Schritte ist ein Tippfehler um 3 Uhr nachts.
Wir wollten, dass die öffentliche IP der VM folgt: ohne manuellen Schritt und mit einer Ausfallzeit im einstelligen Sekundenbereich. Genau das macht der Network-Reconciler.
Was der Network-Reconciler tut
Der Network-Reconciler ist ein Daemon, der auf jedem Proxmox-Node läuft. Er hört auf drei Datenquellen (unten) und erledigt bei jedem Start, Stopp oder jeder Migration einer VM zwei Dinge auf dem Node, auf dem die VM jetzt läuft:
- Er schreibt eine nftables-NAT-Regel, sodass Traffic für die öffentliche IP an die interne IP der VM weitergeleitet wird (DNAT) und der ausgehende Traffic der VM die öffentliche IP als Absender trägt (SNAT).
- Er legt die öffentliche IP als /32-Adresse auf das Loopback-Interface des Nodes. FRR verteilt Connected-Routen in BGP, der Router lernt also innerhalb von Sekunden, welcher Node die IP gerade besitzt.
Auf dem Node, den die VM verlassen hat, werden dieselben Regeln entfernt. Am Router ändert sich keine Konfiguration: Er bekommt nur eine neue BGP-Route.
Drei Datenquellen
Damit die aktuellen Netzwerkdaten immer zeitnah und korrekt angewendet werden, prüft der Reconciler drei Quellen.
1. proxmox-eventbus: Cluster-Events in Echtzeit
proxmox-eventbus ist ein intern entwickelter Daemon, der auf jedem Proxmox-Node läuft, das lokale Task-Log per inotify beobachtet, jedes Event mit Daten aus /etc/pve anreichert und es als CloudEvents-Nachricht auf einem eingebetteten NATS-Bus veröffentlicht. Die NATS-Instanzen bilden ein Full Mesh über die Nodes; es gibt keinen separaten Broker, keinen Load Balancer und kein DNS zu betreiben, und mTLS nutzt die Zertifikate, die Proxmox bereits in /etc/pve hat. Die Subjects folgen dem Muster pve.cluster.node.kind.vmid.action.phase, ein Subscriber kann also genau auf „Migration von VM 999 abgeschlossen“ hören und auf nichts anderes.
Der Network-Reconciler abonniert Start-, Stopp- und Migrations-Events. Migriert eine VM vom Node weg, entfernt der Reconciler ihre NAT-Regel und Loopback-Adresse; migriert eine VM auf den Node, holt er deren Netzwerkkonfiguration (sofern nicht schon vorab geladen) und wendet sie an. proxmox-eventbus muss auf jedem Node installiert sein, den Sie überwachen wollen; es wird als .deb-Paket für amd64 und arm64 ausgeliefert und startet als systemd-Unit.
2. NetBox: Source of Truth für öffentliche IPs
NetBox ist der Ort, an dem wir dokumentieren, welche öffentliche IP zu welcher VM gehört. Es hat eine gut dokumentierte API und konfigurierbare Webhooks, der Reconciler wird also bei jeder Änderung an einer IP-Adresse, einer virtuellen Maschine oder einem Interface benachrichtigt. Nötig sind nur eine Event Rule für diese Objekttypen und ein Webhook, der dieser Regel zugeordnet ist. Ist es in der Reconciler-Konfiguration aktiviert, werden beide automatisch angelegt.
3. Gemeinsame Konfigurationsdateien: der Fallback
NetBox kann wegen eines Node-Ausfalls oder eines fehlgeschlagenen Updates nicht erreichbar sein, und manchmal will ein Admin eine schnelle Änderung, ohne NetBox zu öffnen. Für beide Fälle speichert der Reconciler jede empfangene VM-Konfiguration in einer eigenen Datei, benannt nach der VM-ID. Ist eine VM-Konfiguration aus NetBox nicht verfügbar, sucht er diese Datei und wendet sie an. Ein Admin kann die Datei für einen Test auch von Hand anlegen und später in NetBox überschreiben.
Weil VMs zwischen Nodes wandern, liegen diese Dateien in /etc/pve/network-reconciler. Die Synchronisation übernimmt damit Proxmox selbst, und jeder Online-Node im Cluster sieht dieselben Dateien.
Netzwerk-Setup
Sind proxmox-eventbus und Network-Reconciler auf jedem Node installiert und ist NetBox erreichbar (in einer der VMs reicht, ist aber nicht zwingend), bleibt ein Node mit FRR als Router. Router und Nodes müssen dieselbe BGP-AS-Nummer verwenden; im Beispiel ist das 65050. Alle Nodes, die dazugehören sollen, sind als Neighbors eingetragen. Die Prefix-Listen sorgen dafür, dass der Router von den Nodes nur /32-Adressen aus dem privaten Bereich annimmt und nichts zurückannonciert.
frr defaults traditional
hostname edge-router
service integrated-vtysh-config
!
ip prefix-list ACCEPT-PRIVATE seq 10 permit 172.16.0.0/12 le 32
!
ip prefix-list REJECT-ALL seq 10 deny 0.0.0.0/0 le 32
!
router bgp 65050
 bgp router-id 10.101.50.10
 no bgp default ipv4-unicast
 !
 neighbor PVE-PEERS peer-group
 neighbor PVE-PEERS remote-as 65050
 neighbor PVE-PEERS timers 10 30
 !
 neighbor 10.101.50.200 peer-group PVE-PEERS
 neighbor 10.101.50.201 peer-group PVE-PEERS
 neighbor 10.101.50.202 peer-group PVE-PEERS
 !
 address-family ipv4 unicast
  neighbor PVE-PEERS activate
  neighbor PVE-PEERS prefix-list ACCEPT-PRIVATE in
  neighbor PVE-PEERS prefix-list REJECT-ALL out
 exit-address-family
!
line vty
Der Reconciler fasst die FRR-Konfiguration bewusst nicht an: Sie ist netzabhängig, und Routing-Änderungen sollen in der Hand des Admins bleiben. Nach der Installation des Network-Reconciler-Dienstes passt der Admin die FRR-Konfiguration des Nodes anhand der mitgelieferten Beispieldatei so an, dass sie zum auf dem Router konfigurierten Autonomen System passt. Im Beispiel unten müssen nur Hostname und IP pro Node angepasst werden. Die entscheidende Zeile ist „redistribute connected“: Jede /32, die der Reconciler auf das Loopback legt, wird zur BGP-Route. BFD ist aktiviert, damit der Router einen toten Node schneller bemerkt, als es der BGP-Hold-Timer allein erlauben würde.
frr version 10.4.1
frr defaults datacenter
hostname pve01
log syslog informational
service integrated-vtysh-config
!
router bgp 65050
 bgp router-id 10.101.50.200
 no bgp default ipv4-unicast
 coalesce-time 1000
 neighbor BGP peer-group
 neighbor BGP remote-as 65050
 neighbor BGP bfd
 neighbor 10.101.50.10 peer-group BGP
 !
 address-family ipv4 unicast
  neighbor BGP activate
  neighbor BGP soft-reconfiguration inbound
  redistribute connected
 exit-address-family
exit
!
line vty
Eine VM auf einer öffentlichen IP erreichbar machen
Unser Labor ist ein Drei-Node-Cluster (pve01, pve02, pve03) mit zwei Test-VMs. VM 998 liegt auf lokalem LVM-Storage und bezieht ihre Netzwerkkonfiguration aus einer gemeinsamen Konfigurationsdatei. VM 999 liegt auf einem LINSTOR-Shared-Storage-Pool und bezieht ihre Konfiguration aus NetBox. Der Router ist eine separate FRR-Instanz in AS 65050.
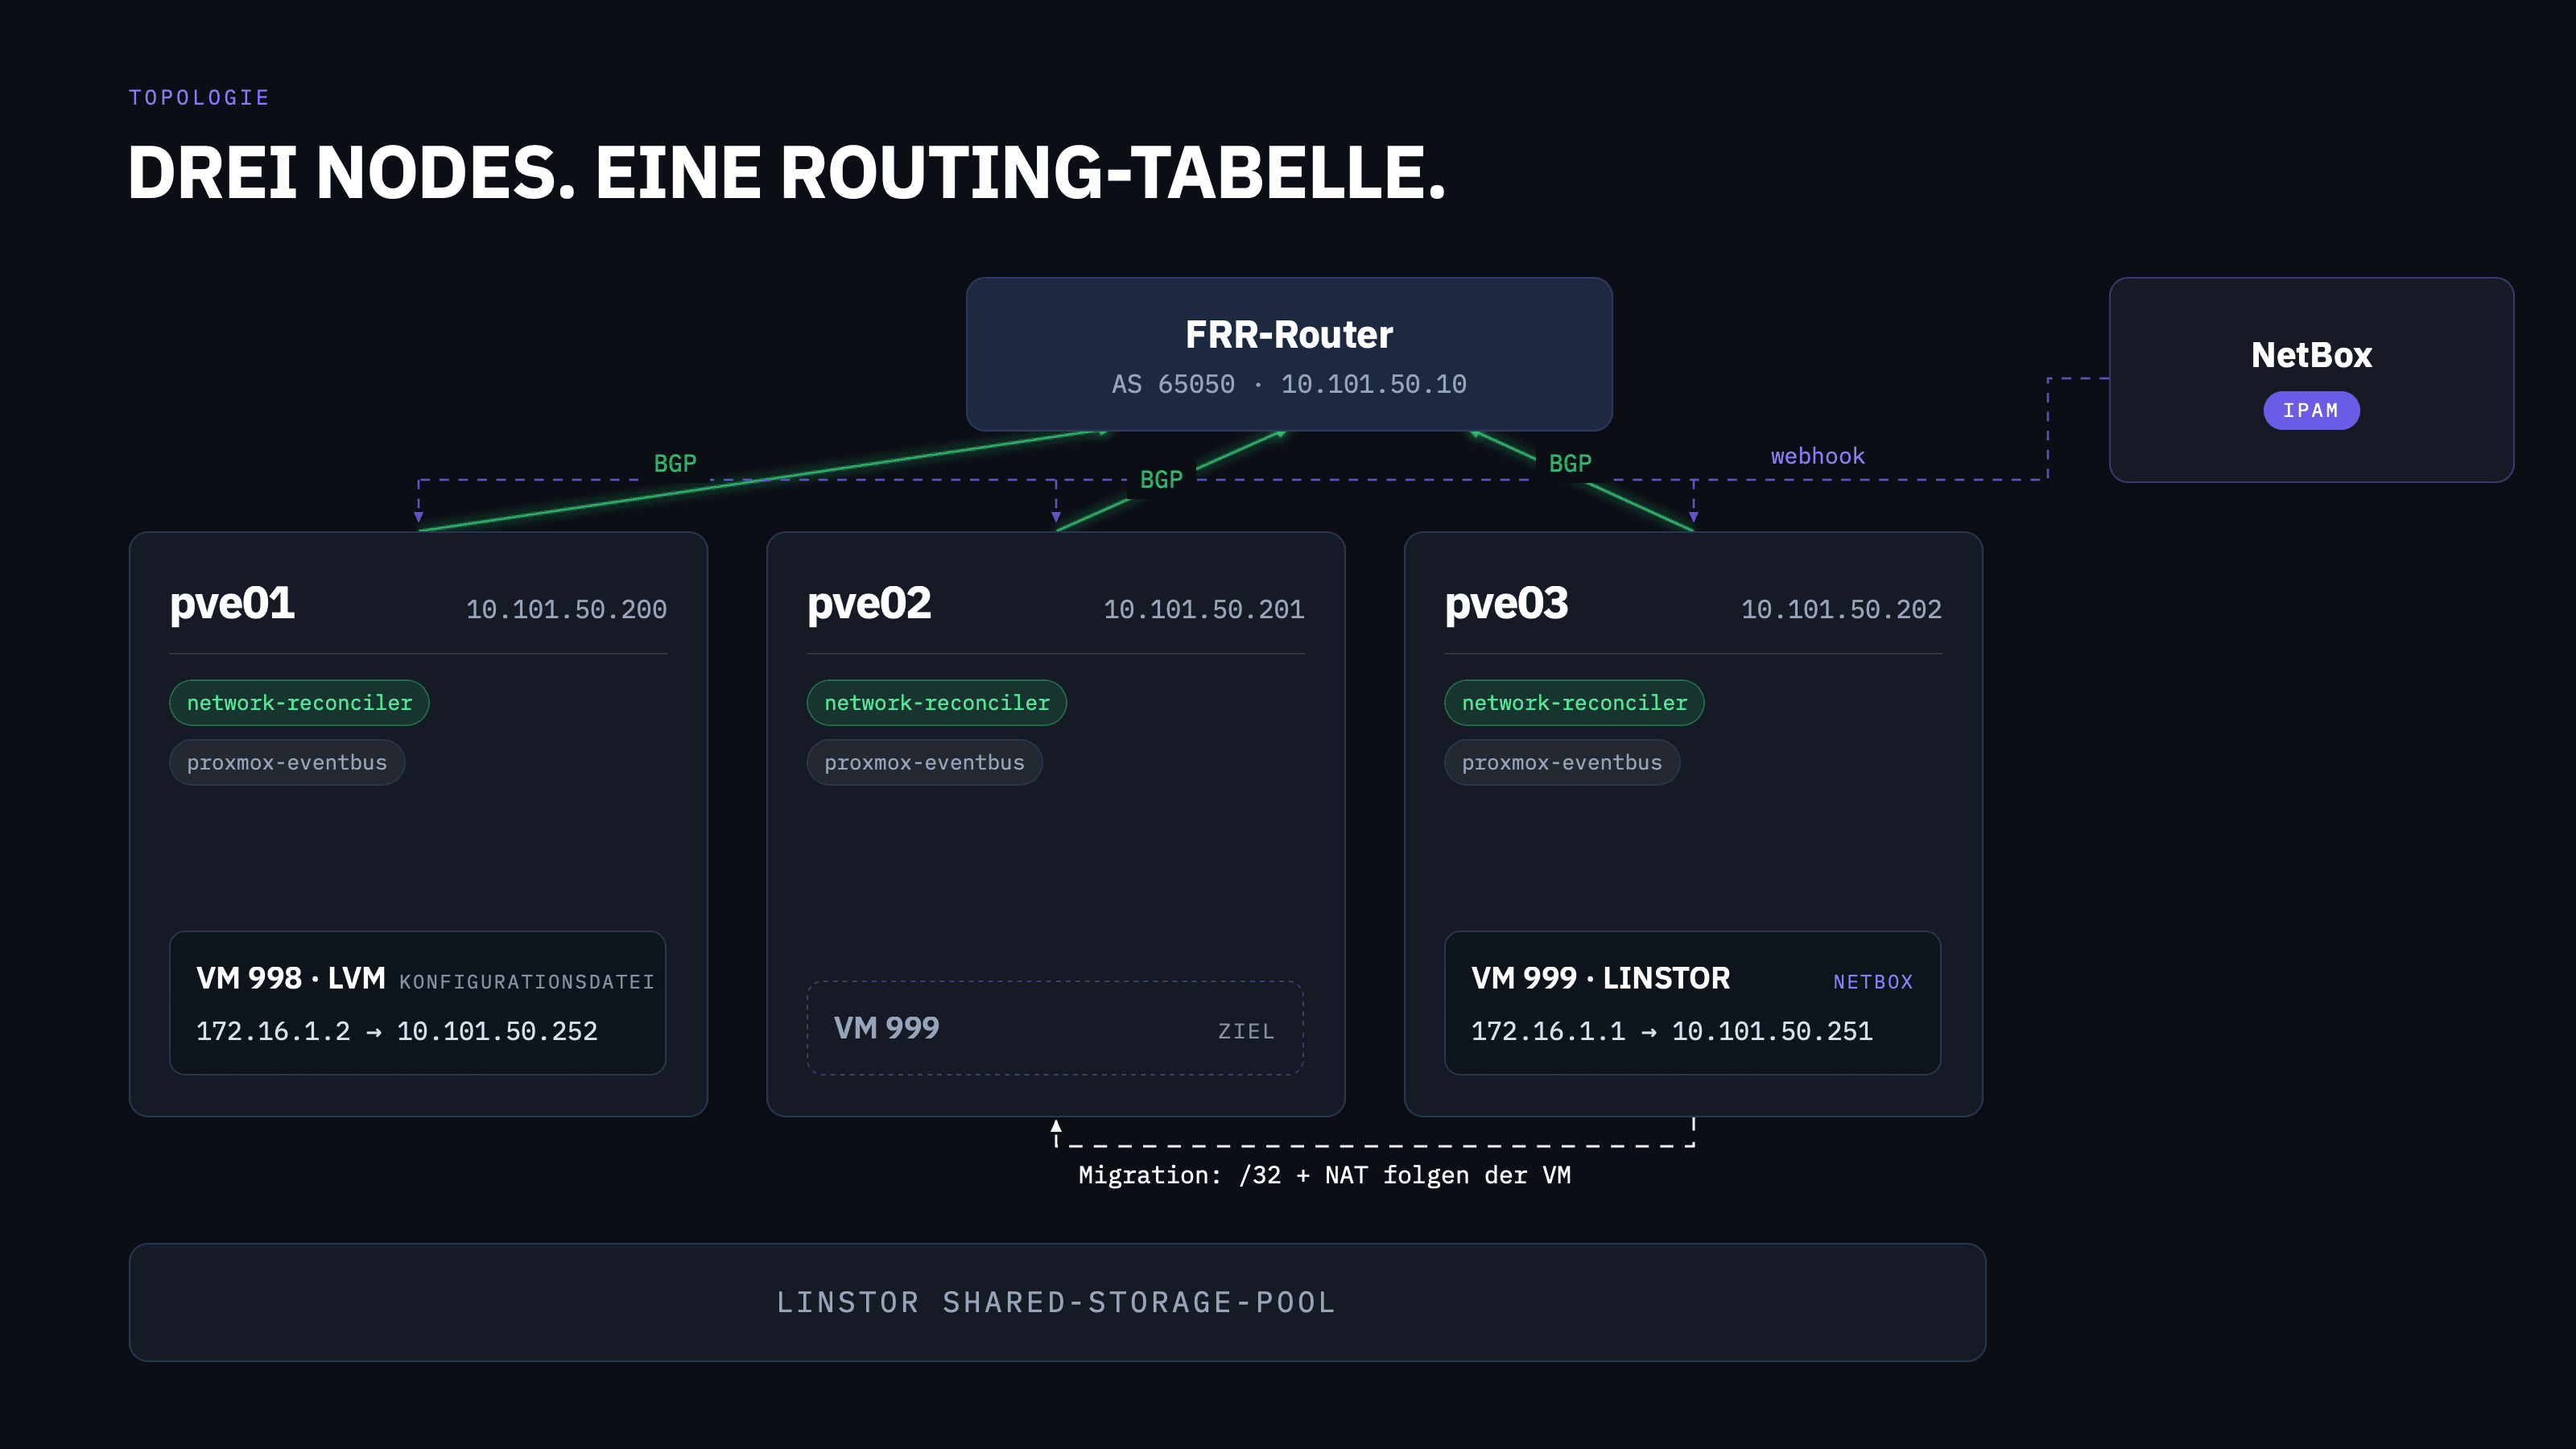
Wird in NetBox eine Konfiguration für eine VM angelegt und erreicht der Webhook den Reconciler, passieren auf dem Node zwei Änderungen.
Erstens muss der Node wissen, dass Traffic an die externe IP eigentlich für eine interne IP bestimmt ist; dafür wird die NAT-Tabelle des Nodes aktualisiert. Für einen Node mit der IP 10.101.50.200, auf dem eine VM mit der internen IP 10.101.50.251 läuft, die als 172.16.1.1 nach außen sichtbar ist, sieht das nftables-Ruleset so aus. Prerouting und Postrouting sind beide nötig, damit die Verbindung in beide Richtungen funktioniert.
table inet network-reconciler {
        chain prerouting {
                type nat hook prerouting priority dstnat; policy accept;
                ip daddr 172.16.1.1 dnat ip to 10.101.50.251
        }

        chain postrouting {
                type nat hook postrouting priority srcnat; policy accept;
                ip saddr 10.101.50.251 snat ip to 172.16.1.1
        }
}
Zweitens muss der Router erfahren, wo die externe IP jetzt liegt. Der Reconciler weist 172.16.1.1/32 dem Loopback-Interface des Nodes zu; FRR verteilt sie in BGP, und der Router weiß, an welchen Node der Traffic geht. Keine statische Route, kein Router-Neustart.
Was bei einer Migration passiert
Wird eine Migration durch einen Node-Ausfall oder einen Admin ausgelöst, benachrichtigt proxmox-eventbus die Reconciler-Instanzen auf Quell- und Ziel-Node. Der Ziel-Node holt die Netzwerkdaten der VM (aus NetBox oder der Konfigurationsdatei) und bereitet sie vor. Kommt die Nachricht „Migration Sync abgeschlossen“, wendet der Ziel-Node NAT-Regel und Loopback-Adresse an, und der Quell-Node entfernt seine Kopien. Um zu sehen, wie sich das auf die Erreichbarkeit auswirkt, haben wir die öffentliche IP während der Migration durchgehend angepingt.
VM 998: lokaler LVM-Storage
Das erste Beispiel ist VM 998 auf normalem LVM-Storage, migriert rein durch Proxmox (die Disk wird während der Migration kopiert).
64 bytes from 172.16.1.2: icmp_seq=37 ttl=64 time=0.645 ms
64 bytes from 172.16.1.2: icmp_seq=38 ttl=64 time=0.485 ms
64 bytes from 172.16.1.2: icmp_seq=39 ttl=64 time=0.661 ms
64 bytes from 172.16.1.2: icmp_seq=40 ttl=64 time=1.14 ms
64 bytes from 172.16.1.2: icmp_seq=44 ttl=64 time=0.816 ms
64 bytes from 172.16.1.2: icmp_seq=45 ttl=64 time=0.484 ms
^C
--- 172.16.1.2 ping statistics ---
45 packets transmitted, 42 received, 6.66667% packet loss, time 45074ms
Drei Pakete (Sequenz 41 bis 43) gingen verloren, direkt danach stieg die Latenz auf rund 1 ms. Drei verlorene Pings im Sekundentakt bedeuten etwa drei Sekunden, in denen der Dienst nicht erreichbar war. Die Ursache ist nicht das Routing. Ohne replizierten Storage muss die Disk für die Migration verschoben werden; Proxmox erledigt das mit qm move-disk, das im Hintergrund einen QEMU-Drive-Mirror-Job startet und dessen Status im Sekundentakt bei QEMU abfragt. Während des Cutovers ist das I/O pausiert, und es dauert meist zwei Abfragen, manchmal drei, bis QEMU den Erfolg meldet. Das sind die zwei bis drei Sekunden im Ping-Log.
VM 999: LINSTOR-Shared-Storage
Das zweite Beispiel ist VM 999 auf einem Shared-Storage-Pool unter LINSTOR, das das Volume auf allen Pool-Nodes repliziert hält. Die Migration muss die Disk gar nicht bewegen: LINSTOR macht den neuen Node zum Primary, und die VM läuft sofort weiter. Jedes Paket kam an, die Verzögerung ist im Ping-Log nicht sichtbar.
PING 172.16.1.1 (172.16.1.1) 56(84) bytes of data.
64 bytes from 172.16.1.1: icmp_seq=1 ttl=64 time=0.667 ms
64 bytes from 172.16.1.1: icmp_seq=2 ttl=64 time=0.546 ms
64 bytes from 172.16.1.1: icmp_seq=3 ttl=64 time=0.555 ms
64 bytes from 172.16.1.1: icmp_seq=4 ttl=64 time=0.470 ms
64 bytes from 172.16.1.1: icmp_seq=5 ttl=64 time=0.621 ms
64 bytes from 172.16.1.1: icmp_seq=6 ttl=64 time=1.68 ms
64 bytes from 172.16.1.1: icmp_seq=7 ttl=64 time=0.598 ms
64 bytes from 172.16.1.1: icmp_seq=8 ttl=64 time=0.476 ms
64 bytes from 172.16.1.1: icmp_seq=9 ttl=64 time=0.680 ms
64 bytes from 172.16.1.1: icmp_seq=10 ttl=64 time=0.774 ms
64 bytes from 172.16.1.1: icmp_seq=11 ttl=64 time=0.497 ms
64 bytes from 172.16.1.1: icmp_seq=12 ttl=64 time=0.500 ms
64 bytes from 172.16.1.1: icmp_seq=13 ttl=64 time=0.514 ms
64 bytes from 172.16.1.1: icmp_seq=14 ttl=64 time=0.561 ms
64 bytes from 172.16.1.1: icmp_seq=15 ttl=64 time=0.421 ms
64 bytes from 172.16.1.1: icmp_seq=16 ttl=64 time=0.745 ms
64 bytes from 172.16.1.1: icmp_seq=17 ttl=64 time=0.381 ms
64 bytes from 172.16.1.1: icmp_seq=18 ttl=64 time=0.456 ms
Fazit: Mit Shared Storage wie LINSTOR, DRBD oder Ceph ist die Netzwerkseite einer Migration nicht der Engpass. Das Routing-Update ist schneller als die Migration selbst. Wer Ceph betreibt, findet in unserem Artikel Linux-Defaults für Ceph-Performance das Tuning auf der Storage-Seite.
Wann Sie das nicht brauchen
Seien Sie ehrlich mit der Größe Ihres Clusters, bevor Sie einen weiteren Daemon auf die Nodes legen.
- Kleiner Cluster, wenige öffentliche IPs, seltene Migrationen: Eine statische Route pro Node plus eine dokumentierte NAT-Regel reicht, und es ist ein bewegliches Teil weniger.
- Sie betreiben bereits Proxmox SDN mit einer EVPN-Zone (die SDN-Kernpakete sind seit Proxmox VE 8.1 standardmäßig installiert). SDN löst Overlay-Netze zwischen VMs über Nodes hinweg und kann EVPN-Routen über Exit Nodes an einen externen BGP-Peer exportieren. Deckt das Ihre Anforderungen an öffentliche IPs bereits ab, bleiben Sie dabei. Der Network-Reconciler zielt auf einen anderen Fall: einfache gebridgte VMs mit NAT auf dem Node, öffentliche IPs in NetBox dokumentiert, kein Overlay-Netz.
- Ihre öffentlichen IPs sind Floating IPs eines Cloud- oder Hosting-Anbieters mit eigener API. Nutzen Sie diese API; BGP kommt dann nicht dazu.
- Sie haben kein NetBox und planen keins. NetBox-URL und Token sind in der Reconciler-Konfiguration Pflicht; der Fallback über Konfigurationsdateien deckt einen NetBox-Ausfall ab, nicht ein fehlendes NetBox.
Bekannte Einschränkungen
- Der Reconciler läuft als root (er muss für die gemeinsamen Konfigurationsdateien nach /etc/pve schreiben), bearbeitet die FRR-Konfiguration aber absichtlich nie. Die bleibt ein manueller, einmaliger Schritt pro Node.
- Läuft der Reconciler auf dem Ziel-Node nicht, gelingt die Migration, aber die öffentliche IP zieht nicht mit. Überwachen Sie die systemd-Unit wie jeden anderen Cluster-Dienst.
- Die Ping-Tests oben stammen aus einem Drei-Node-Labor. Die Migrationsverzögerung auf lokalem Storage hängt von Disk-Größe und Netzdurchsatz ab; die drei Sekunden gelten für eine 20-GB-Disk über das Labornetz.
- Getestet mit Proxmox VE 9.2.3, FRR 10.4.1 auf den Nodes und FRR 8.4.4 auf dem Router sowie NetBox 4.6.4 mit v1-API-Tokens; Unterstützung für v2-Tokens ist geplant. Die Ping-Tests oben stammen aus einem Drei-Node-Labor.
- Nur IPv4. IPv6 wird derzeit nicht unterstützt.
Der Code
Beide Tools sind auf Hostzeros GitHub veröffentlicht.
- proxmox-eventbus: Go, Apache-2.0, .deb-Pakete für amd64 und arm64. Der Post-Install-Hook legt den Service-User an, fügt ihn zu www-data hinzu, damit er /etc/pve lesen kann, und startet die systemd-Unit.
- network-reconciler: Go, Apache-2.0. Läuft als systemd-Unit; Konfiguration in /etc/network-reconciler/config.yaml, NetBox-Token in /etc/network-reconciler/environment. Deployment auf alle Nodes per make deploy nach Anpassung der Variable HOSTS im Makefile, oder Paket per make package bauen, pro Node installieren und mit systemctl enable --now network-reconciler starten. Voraussetzungen: Proxmox-Cluster (getestet mit PVE 9), Router-Node mit FRR, proxmox-eventbus auf jedem Node und eine NetBox-v4-Instanz.
Issues und Pull Requests sind willkommen. Wer das auf einem größeren Cluster als unserem betreibt: Wir wollen die Zahlen sehen.
Was wir bei Hostzero tun
Wir betreiben und betreuen Proxmox-Cluster für Unternehmen in der EU aus unserem Rechenzentrum in Frankfurt, einschließlich Migrationen von VMware. Der Network-Reconciler ist aus dieser Arbeit entstanden: aus Kunden-Setups, in denen VMs täglich zwischen Nodes wandern und danach niemand einen Router anfassen soll. Wenn Sie einen Cluster planen oder von VMware zu Proxmox migrieren, sehen Sie sich unser Angebot Proxmox VE Migration und Support an. Für die Shared-Storage-Seite kümmert sich unser Team für Ceph-Planung und -Betrieb um den Storage, der die verlustfreie Migration von oben möglich macht.
Häufige Fragen
Verschiebt Proxmox HA die öffentliche IP einer VM automatisch?
Nein. HA startet oder migriert die VM auf einem anderen Node, aber jede NAT-Regel oder statische Route, die auf den alten Node zeigt, bleibt, wo sie war. Die Erreichbarkeit über die öffentliche IP muss separat wiederhergestellt werden; genau das automatisiert der Network-Reconciler.
Warum BGP und nicht eine gemeinsame virtuelle IP mit keepalived oder VRRP?
VRRP funktioniert für eine IP, die sich ein festes Host-Paar teilt. Hier kann jede VM auf jedem Node landen, und jede VM hat ihre eigene öffentliche IP. Jede IP als /32-Route von dem Node zu annoncieren, der sie gerade besitzt, skaliert auf beliebig viele IPs und Nodes, ohne Paare vorab zu definieren.
Wie viel Ausfallzeit verursacht eine Migration mit diesem Setup?
In unserem Labor drei verlorene Pings (rund drei Sekunden) bei einer VM auf lokalem LVM-Storage und kein Paketverlust bei einer VM auf LINSTOR-Shared-Storage. Das Routing-Update selbst ist schneller als die Migration.
Muss ich NetBox betreiben?
Ja, URL und Token einer NetBox-v4-Instanz sind in der Konfiguration Pflicht. Ist NetBox nicht erreichbar, weicht der Reconciler auf VM-Konfigurationsdateien in /etc/pve/network-reconciler aus, die Proxmox im Cluster synchronisiert; ein NetBox-Ausfall blockiert also keine Migration.
Ist das dasselbe wie Proxmox SDN?
Nein. Proxmox SDN baut Overlay-Netze (VLAN, VXLAN, EVPN) zwischen VMs über Nodes hinweg. Der Network-Reconciler hat eine engere Aufgabe: eine öffentliche IP mit NAT auf dem Node erreichbar halten, wenn eine gebridgte VM migriert, gesteuert über NetBox.
Ist der Code produktionsreif?
proxmox-eventbus steht bei v0.1.0, und wir betreiben es auf unseren eigenen Clustern. Behandeln Sie beide Tools als frühe Releases: Code lesen, zuerst auf einem Labor-Cluster testen und ein Issue öffnen, wenn etwas bricht.
Sprechen Sie mit einem Experten
Sie planen einen Proxmox-Cluster oder haben einen, in dem VMs und IPs auseinandergelaufen sind? Sprechen Sie mit einem Experten: 30 Minuten, kein Verkaufsgespräch.
Haben Sie Fragen zu diesem Thema?
Unsere Experten beraten Sie gerne zu Ihrer individuellen Strategie.
Beratungsgespräch vereinbaren